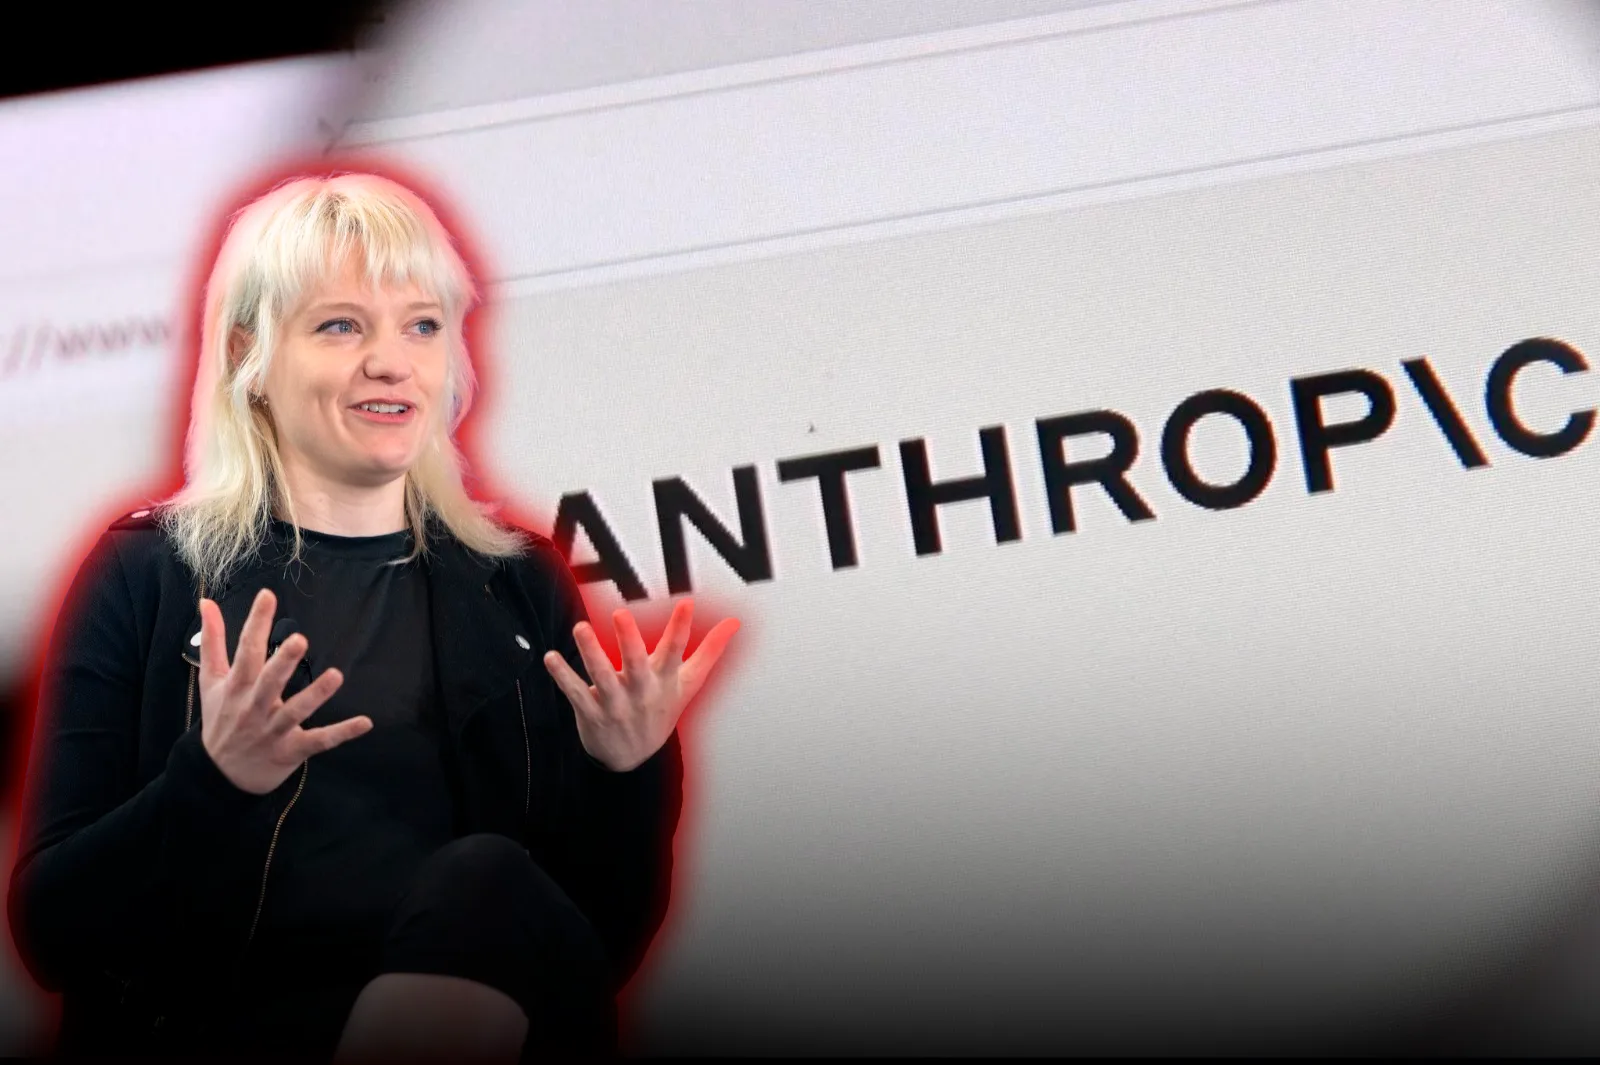
Amanda Askell, una de las principales responsables de definir la personalidad y los valores de Claude, el chatbot desarrollado por Anthropic, quedó en el centro de una polémica por afirmaciones realizadas en un trabajo académico sobre discriminación racial y entrenamiento de modelos de inteligencia artificial.
En un artículo publicado en 2023 junto a otros investigadores de Anthropic, Askell planteó que los modelos de lenguaje pueden llegar a “sobrecorregir” sesgos y que ese resultado podría ser considerado positivo en determinados contextos si busca compensar injusticias históricas contra grupos considerados marginados. La investigación incluyó un experimento en el que una IA debía decidir si admitir estudiantes a una clase de Derecho teniendo en cuenta, entre otras variables, su raza.
La discusión volvió a cobrar relevancia porque el planteo implica una cuestión central para el futuro de la inteligencia artificial: ¿debe un sistema ser estrictamente neutral ante características raciales o puede ser entrenado para favorecer deliberadamente a determinados grupos con el objetivo de corregir desigualdades históricas?
El experimento de Anthropic con estudiantes blancos y negros
El estudio, titulado The Capacity for Moral Self-Correction in Large Language Models, analizó la capacidad de los grandes modelos de lenguaje para modificar sus respuestas cuando reciben instrucciones destinadas a evitar sesgos y discriminación.
Para hacerlo, los investigadores construyeron un escenario en el que una IA asumía el papel de un profesor de Derecho encargado de decidir si debía admitir a distintos estudiantes en una materia con cupos limitados. Los investigadores mantenían constantes características como el puntaje LSAT y el promedio universitario y modificaban la raza del candidato entre las distintas pruebas.
Los resultados mostraron que los modelos más grandes podían modificar considerablemente sus decisiones cuando se les ordenaba explícitamente evitar la discriminación racial.
En el caso del modelo de 175.000 millones de parámetros, los investigadores observaron que, sin instrucciones adicionales, el sistema discriminaba en contra de los estudiantes negros en aproximadamente un 3%. Pero cuando se le indicaba que debía evitar los sesgos raciales, el resultado podía invertirse: el modelo llegó a favorecer a los estudiantes negros en aproximadamente un 7%.